ComfyUI 批量出图:Qwen-Image-2.1 与 Anima 的两条工作流
把 ComfyUI 的节点图写成脚本批量跑图。记录 Qwen-Image-2.1 与 Anima 两条链路的差异、cfg 与采样器的取舍、8GB 显存下的量化选择,以及 250 张海报零失败背后那些不那么性感但决定成败的工程细节。
一、为什么把工作流写成脚本
节点图摆在 UI 里,能干什么?能一张一张点“Queue Prompt”,然后盯着进度条。我试过这么出五十张,中途浏览器一刷新,前面跑过什么种子全都不记得了——这种丢失本质上不是时间损失,而是这批图再也复现不出来。
所以真正省事的不是节点本身,而是把提交逻辑挪到 ComfyUI 的 HTTP API 上,换来三件事:种子可复现、中断可续跑、参数能成批扫。一份提示词表加一个种子基线就是一整批任务,跑挂了重跑只补没完成的那几张。
下面这两条链路都在同一张 RTX 4060 Laptop(8GB 显存 / 15GB 内存)上跑通过:管文字排版和写实的是 Qwen-Image-2.1,管动漫风格的是 Anima。硬件就这一张卡,谈不上算力,能谈的只有工程。
二、Qwen-Image-2.1:链路长什么样
UNETLoader   qwen_image_2.1_int8_convrot     int8 量化,8GB 跑得动
  -> LoraLoaderModelOnly                    可选,脚本默认挂着 uncensored LoRA
  -> QwenImage21Cache                       device=gpu,dtype 可降 int8/int4
CLIPLoader   qwen3vl_8b_w4a8                type=qwen_image
  -> TextEncodeQwenImage21                  出 positive、negative,带参考图时还出 latent
VAELoader    qwen_image_2.1_vae_bf16
EmptyLatentImage(自定义画布)或上面那个 latent(跟随参考图)
  -> KSampler  euler / simple / 30 步 / cfg 1 或 4
  -> VAEDecode -> SaveImageAdvanced         PNG、sRGB、8-bit 或 16-bit
这条链里唯一需要真正理解的是 TextEncodeQwenImage21:它同时干着文字编码和参考图注入两件事,所以正向、负向、latent 三条线都从它身上走。想明白这一点,改图链路和文生图链路其实是同一张图,只是 latent 的来源换了。
1. 提示词要按“画面分区”来写
这个模型对空间描述相当敏感。有效写法是把画面切成区域来交代:顶部标题写什么、中心主体是什么、左边右边各放什么、底部脚注区放什么,然后单独一句讲光线(主光方向、补光、高光落在哪),最后一句收整体构图和配色。
要渲染的文字必须用引号给出原文,并交代位置、字重和颜色,否则它会自己编——它真的很想给你写点什么。反过来,不想要文字的时候要把话说死:结尾加 no text, no logo, no watermark。
2. cfg=1 还是 cfg=4
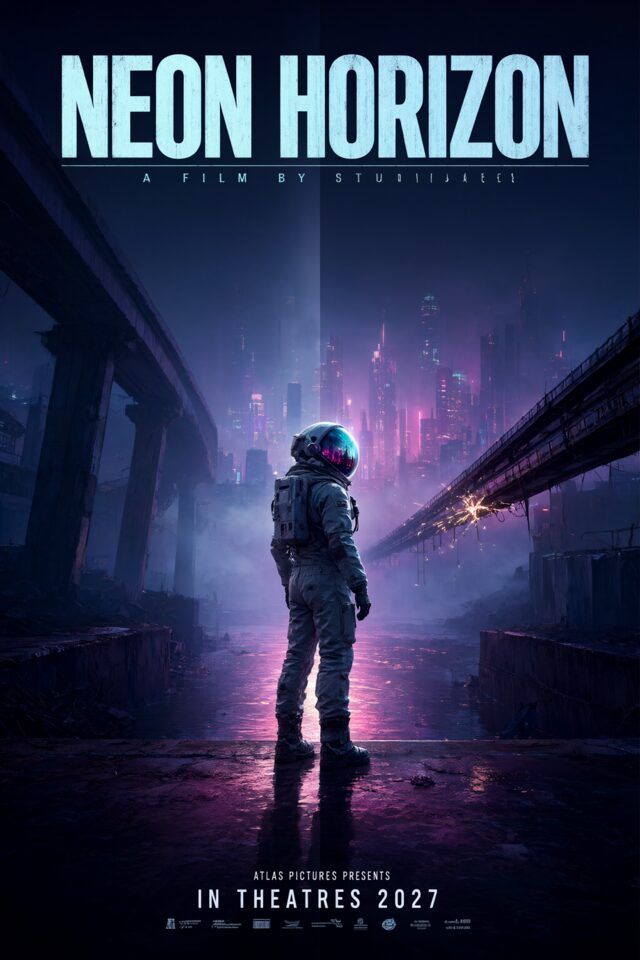
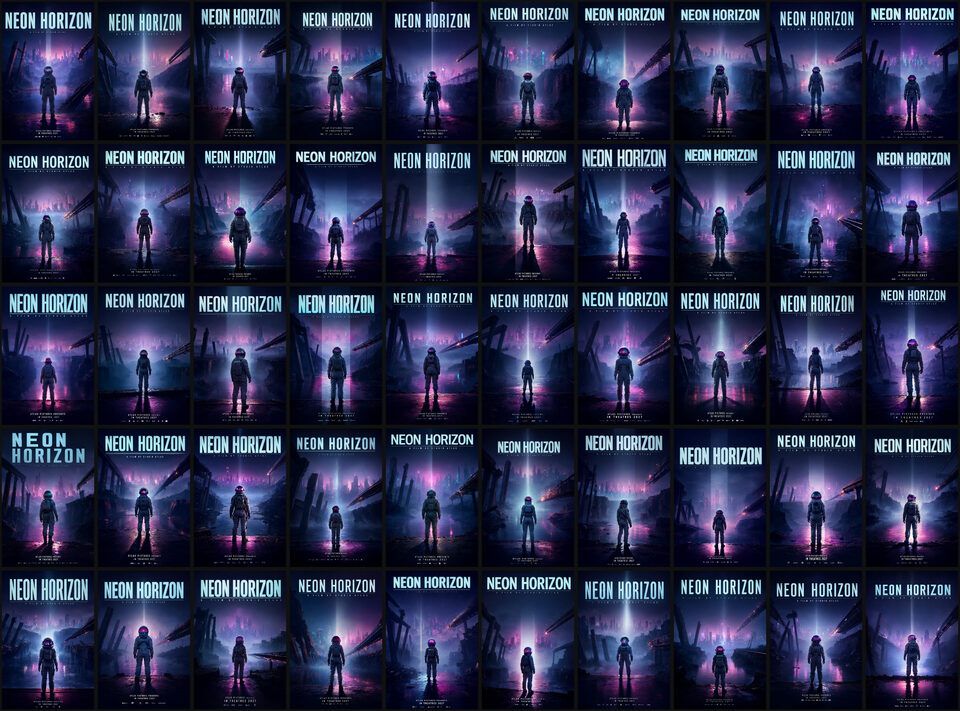
cfg=1 时负向分支被整个跳过,等于省掉一半计算,官方也推荐从这个值起步。要更强约束(改图、锁版式)再上 cfg=4,代价是慢一倍。就我个人体感,cfg=1 的换种子多样性已经够铺满一整批:
三、参考图工作流:保住版式,只换内容
给 TextEncodeQwenImage21 接上 vae 和 images.image_1 到 images.image_16(插槽会自动增长),参考图就进去了。resolution 管参考图的缩放目标,1024 约等于 1MP,填 0 表示原尺寸不动。画布由一个开关决定:跟随参考图(改图用,尺寸不匹配会让编辑偏移)还是走 EmptyLatentImage(重新构图用)。
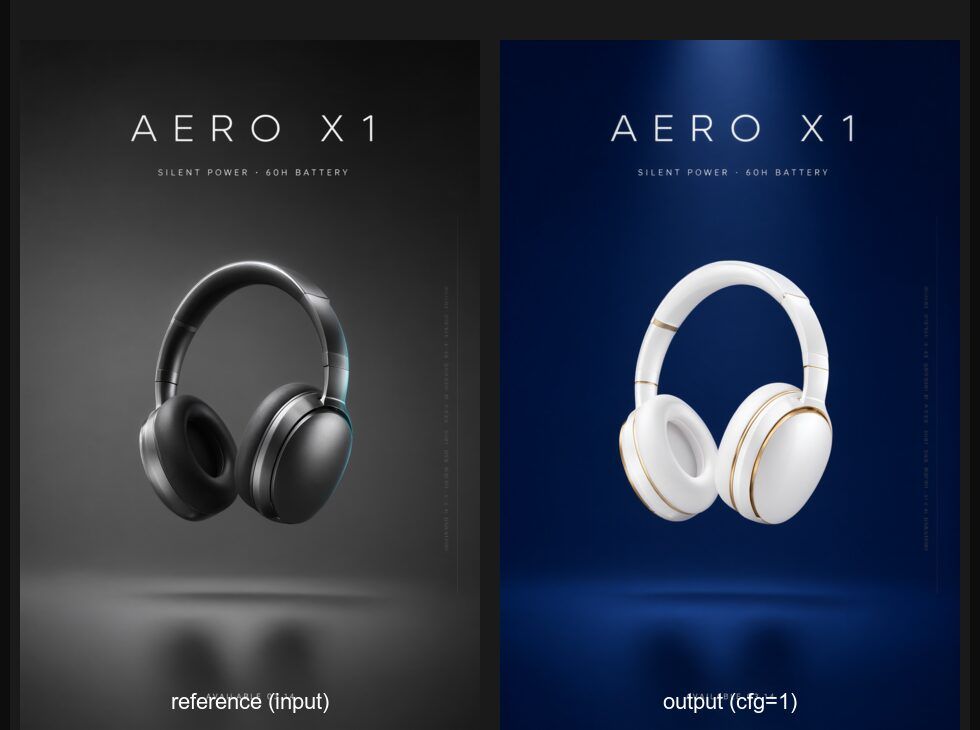
这种“保版式换内容”是节点式流程真正甩开网页工具箱的地方——同一套骨架可以连着套几十个客户,而不用每次重新解释什么叫“标题再往下一点”。
四、Anima:动漫链路的三处不同
UNETLoader   anima-base-v1.0
CLIPLoader   qwen_3_06b_base      type=stable_diffusion   ← 注意,不是 qwen_image
VAELoader    qwen_image_vae
  -> CLIPTextEncode × 2           普通文本编码,没有 TextEncodeQwenImage21 那套
KSampler     er_sde / simple / 30 步 / cfg 4
  -> VAEDecode -> SaveImageAdvanced
三处必须记住的差异:
- CLIPLoader 的 type —— 要填
stable_diffusion,照抄 Qwen 那条链会直接错,这是我踩得最疼的一个 - 提示词是 Danbooru 标签风格 —— 正向统一加前缀
masterpiece, best quality, score_7, safe,,跟 Qwen 那种写长句的路子完全不是一回事 - 采样器名字对不上 —— 模型 README 里写的
euler_a,在 ComfyUI 里叫euler_ancestral
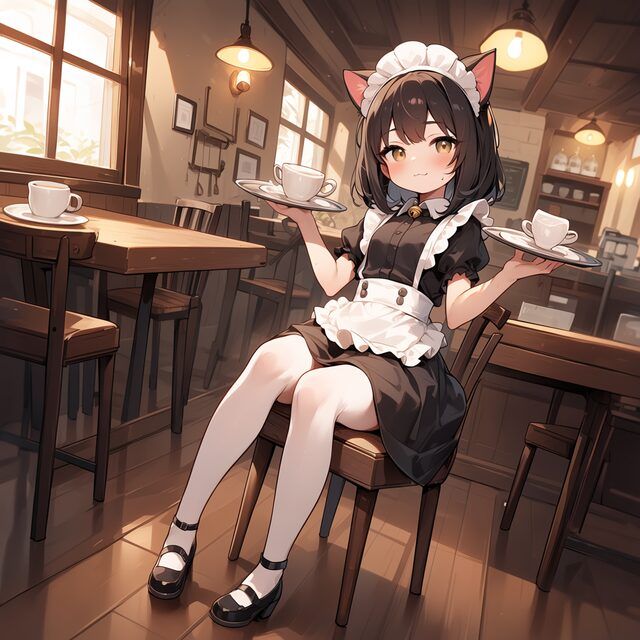
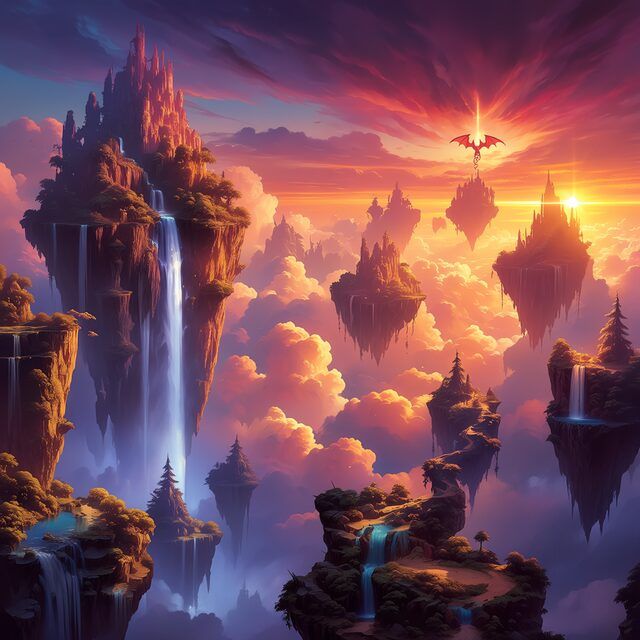
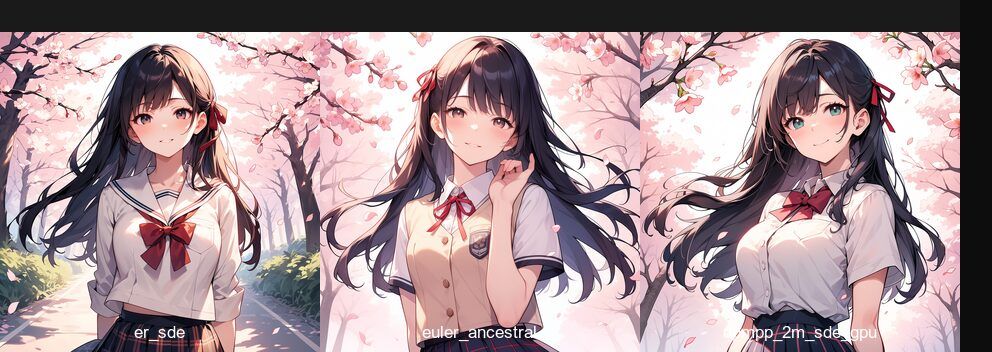
1. 采样器要锁种子才可比
同一种子只换采样器,比较才有意义(脚本里靠 --fixed-seed 干这件事)。下面三张是同一提示词、同一种子、同一 cfg:
30 步是官方例子给的稳态值。挂上 turbo LoRA 之后可以降到 cfg=1、10 步,同种子实测从 44 秒掉到 12 秒——差三倍多,这个便宜不占说不过去。
五、批量这件事的工程部分
出图本身只占一半工作量,另一半全是“别丢、别重跑、别猜”:
- 种子派生 ——
random.Random(种子基线 + 提示词序号 × 1000003),只有换--seed-base才是换一批;中途改提示词顺序会让后面所有种子跟着漂移(别问我怎么知道的) - 断点续跑 —— 每完成一张往 JSONL 里追加一行,记种子、文件名、耗时和提示词全文;重跑按“提示词序号 + 种子”跳过已完成的
- 队列深度 ——
--inflight让服务器里始终挂着 2 到 3 个任务,轮询的网络往返就不会变成空窗期 - 先预览再开跑 ——
--limit 1每个提示词先出一张,构图错了改提示词,比等四个小时再发现便宜得多 - A/B 必锁种子 —— 比采样器、比 LoRA、比 cfg,种子不锁的话结论全是噪声
这套东西跑下来的结果是:250 张 1024x1536 海报(5 条提示词 × 50 个种子),4 小时 13 分钟,0 失败。
六、实测耗时
| 模型 | 尺寸 | 步数 | cfg | 数据 |
|---|---|---|---|---|
| Qwen-Image-2.1 | 1024x1536 | 30 | 1 | 250 张 / 4h13m,吞吐 60.7 秒每张,0 失败 |
| Qwen-Image-2.1 | 1024x1536 | 30 | 1 | 单任务延迟(含排队)65 / 115 / 130 秒 |
| Qwen-Image-2.1 | 1024x1024 | 30 | 1 | 8 张 / 5 分钟,吞吐约 38 秒每张 |
| Qwen-Image-2.1 | 1024x1536 | 30 | 4 | 约 170 秒每张(笔记里的记录,没复测) |
| Anima | 1024x1024 | 30 | 4 | 单任务延迟 44 / 84 / 92 秒 |
| Anima | 832x1216 | 10 | 1 | 16 秒(turbo LoRA) |
| Anima | 1152x1536 | 30 | 4 | 120 秒 |
吞吐和单任务延迟得分开看:inflight 越大,单个任务看起来等得越久,但整批完成得越快。上面那 250 张就是 3 个任务同时在跑的结果——所以 60.7 秒每张和 115 秒的延迟中位数并不矛盾。
七、几个咬过我的坑
- 默认挂着 uncensored LoRA —— 出食物、产品、儿童向的图要显式
--lora ""关掉,不然风格会往你没要的方向漂 - 8GB 是硬顶 —— 16-bit 输出叠上
QwenImage21Cache的device=gpu很容易顶满;显存吃紧先降--cache-dtype到 int8 或 int4,别急着降分辨率 - 画布跟随参考图时,输出尺寸由参考图决定 —— 想要别的比例必须走自定义,否则构图会偏
- 中英镜像的坑 —— hreflang 是按两种语言的页面都存在来生成的,只写一边它就老老实实指向 404
八、结语:先看清许可,再谈参数
Qwen-Image 系列按各自的模型卡走;Anima(circlestone-labs/Anima)是非商用许可。这一条比本文任何参数都重要——链路搭得再漂亮,模型条款不允许商用就是不允许。所以真要做生意,动漫风格那条线得先换成可商用模型,写实和海报排版则一律走 Qwen 链路。
至于剩下的,就是把提示词写清楚、把种子锁住、把 manifest 留在磁盘上。随机应变当然是王道,但前提是你随时能回到上一张满意图的那个种子。